
Introduction
Avant d’ajouter un outil à une chaîne de sécurité, une seule question compte : que couvre-t-il que les autres ne couvrent pas déjà ?
Nous nous la sommes posée pour Nuclei. Il est très présent dans l’écosystème DevSecOps, et il est souvent recommandé en duo avec ZAP Proxy dans une grande partie des guides de sécurité applicative.
Nous l’avons évalué sur les toutes les formes que prennent réellement nos projets, parce que la réponse n’est pas la même sur chacune :
- une application Symfony à rendu serveur, dont les vues sont des templates Twig
- une application Symfony dont les vues passent par Inertia et Vue au lieu de Twig
- une SPA Vue.js, servie comme un bundle statique et adossée à une API ;
- un site statique buildé par Astro, comme celui que vous lisez
- une documentation technique sous VitePress
Installation, pipeline locale, templates maison, scans comparés à ceux de ZAP Proxy : nous avons finalement décidé de
ne pas l’intégrer à notre suite d’outils sécurité. Non parce que l’outil serait mauvais, il ne l’est pas, mais parce
que ce qu’il trouve chez nous, nous le savons déjà. L’analyse statique lit le code, composer audit et npm audit
connaissent nos dépendances et leurs CVE avant qu’elles n’atteignent la production, et ZAP Proxy couvre le
comportement de l’application une fois servie. Nuclei se superpose aux trois sans ajouter de surface propre.
Ce recoupement n’est pas un défaut de l’outil, c’est une question de position. Nuclei est fait pour regarder une cible de l’extérieur, sans en connaître le code ni les dépendances : reconnaissance, surface d’attaque d’un tiers, parc dont on hérite. Sur nos projets nous sommes à l’intérieur, avec le dépôt, la chaîne d’intégration et le verrou de dépendances sous la main. L’avantage comparatif de Nuclei, deviner ce qu’on ignore, ne se paie que lorsqu’on ignore quelque chose.
Cet article présente l’outil tel qu’il est, puis explique le cheminement qui nous a menés à ce choix, stack par stack.
En résumé, pour extraire l'essentiel
- Ce qu’est Nuclei : un moteur de règles déclaratives, une par fichier YAML, adossé à plus de treize mille templates communautaires. Rapide, lisible, très réactif sur les CVE récentes.
- Notre décision : ne pas l’ajouter à notre chaîne, à côté de ZAP Proxy. Pas pour un défaut de l’outil, mais
parce qu’un seul de ses usages ne recoupe rien de ce que nous avons déjà : le scan d’un répertoire de build par
le protocole
file. - Et ce gain unique ne survit pas à la mesure : le catalogue qui le sert vise des systèmes de fichiers compromis,
pas des artefacts de build, et la règle maison que nous avons écrite pour combler le manque fait ce qu’un
find dist -name '*.map'fait en une ligne, sans scanner. - Le reste est déjà couvert : le fuzzing par le scan actif de ZAP, la sonde de chemins connus par une
quinzaine de règles dédiées de ce même scan, les CVE de dépendances par
composer auditetnpm audit, le code par l’analyse statique. - Mesuré, pas supposé : sur ce site, le catalogue
file/complet a rendu 818 remontées en près de 25 minutes, dont aucune vraie. Le scan passif de ZAP en rend 7 en 3 minutes, dont 4 faux positifs qu’on peut écarter nommément. - La raison de fond : Nuclei est conçu pour regarder une cible de l’extérieur. Nous sommes à l’intérieur de nos projets, avec le dépôt, la CI et les verrous de dépendances.
- Quand Nuclei est le bon choix : reconnaissance, bug bounty, parc d’actifs dont on hérite sans en connaître le code. Là, il est difficile à remplacer.
1. Nuclei et l’écosystème ProjectDiscovery
ProjectDiscovery est un éditeur open source qui publie une suite d’outils de sécurité écrits en Go, rangés en trois phases : « Discover, Enrich, Detect ».
Nuclei est l’outil de la phase Detect, et le plus connu de la suite : un scanner qui cherche les faiblesses exploitables d’une surface d’attaque à partir d’une bibliothèque de templates.
Une chaîne d’outils, pas un scanner monolithique
Concrètement, les outils de la suite se chaînent par leurs entrées et sorties standard : ce que l’un produit alimente le suivant. Chacun couvre une étape, et une seule, du parcours « découvrir, qualifier, détecter ».
flowchart LR
  A["subfinder<br/>sous-domaines"] --> B["httpx<br/>hôtes vivants"]
  B --> C["katana<br/>crawl des URLs"]
  C --> D["nuclei<br/>détection par templates"]
  D --> E["notify<br/>Slack, webhook"]
  F["schéma OpenAPI"] --> D
  G["liste d'URLs<br/>écrite à la main"] --> D
  style D fill:#2b4bb8,color:#fff
| Outil | Ce qu’il fait |
|---|---|
subfinder | Énumération passive de sous-domaines depuis des sources publiques |
httpx | Sonde HTTP en masse : code de statut, titre, technologies détectées, TLS |
katana | Crawler web, avec un mode navigateur headless capable de suivre une application JavaScript |
nuclei | Le scanner de vulnérabilités, piloté par des templates YAML |
notify | Pousse la sortie d’un outil vers Slack, Discord ou un webhook |
pdtm | Installe et met à jour tous les outils de la suite |
Le reste du catalogue (naabu, dnsx, tlsx, asnmap, cloudlist, uncover, mapcidr, cdncheck) relève de la
reconnaissance d’infrastructure : cartographier des plages réseau, des ports ouverts, des actifs cloud.
Cette organisation dit déjà à qui la suite s’adresse. Elle est pensée pour explorer une surface qu’on ne connaît pas, logique du test d’intrusion et du bug bounty. Retenez ce point, il revient en fin d’article.
Ce que Nuclei fait, et surtout ce qu’il ne fait pas
Nuclei est un scanner dont chaque test est un fichier YAML appelé template. À l’exécution, il charge les templates
sélectionnés depuis ~/nuclei-templates/, envoie les requêtes que chacun décrit, compare la réponse aux critères
déclarés et signale les correspondances.
Le point qui surprend le plus quand on vient de ZAP : Nuclei n’explore pas l’application. Il n’a pas de crawler. Là où ZAP découvre lui-même la surface avec son spider, Nuclei reçoit sa liste de cibles en entrée. Sans katana ni liste d’URLs, il ne teste que ce que ses templates savent sonder depuis la racine d’un domaine.
La surface de scan est donc une donnée d’entrée, pas un résultat. C’est ce qui explique pourquoi la suite compte autant d’outils autour de lui.
Ce qu’il détecte
- Les CVE connues, par empreinte de version renvoyée par le service exposé.
- Les erreurs de configuration : en-têtes de sécurité manquants, mode debug actif en production, CORS permissif.
- Les expositions de fichiers : répertoire
.git, sauvegardes oubliées, panneaux d’administration sans mot de passe. - L’empreinte technologique : version du CMS, serveur web, frameworks front.
- Les secrets renvoyés par erreur dans une réponse HTTP : clés d’API, jetons.
2. Installer Nuclei
Avec Go
C’est la méthode que la documentation officielle met en avant, et la plus simple si la machine a déjà Golang d’installé.
go install -v github.com/projectdiscovery/nuclei/v3/cmd/nuclei@latestUne remarque qui vaut pour toutes les méthodes : préférez une version épinglée à @latest dès que la commande finit
dans un script ou dans une pipeline. Un scan qui change de moteur entre deux exécutions ne se compare plus au précédent.
Avec PDTM, le gestionnaire de la suite
PDTM installe et met à jour tous les binaires ProjectDiscovery d’un coup.
go install -v github.com/projectdiscovery/pdtm/cmd/pdtm@latest
pdtm -install-all
C’est pertinent si vous visez la chaîne complète (katana pour le crawl, httpx pour la qualification, nuclei pour la détection). Pour le seul scanner, cela n’apporte rien de plus que la commande précédente, et cela suppose Go de toute façon.
Avec Docker, la méthode à privilégier
docker pull projectdiscovery/nuclei:latest
docker run projectdiscovery/nuclei:latest -h
Le raisonnement est le même que pour nos commandes d’audit de Dockerfile : rien à installer
sur le poste, la même version de l’outil pour toute l’équipe, et un job de CI qui tourne sans préparer le runner.
En pipeline, épinglez l’image par version ou par empreinte plutôt que d’utiliser latest.
Les templates s’installent à part
Le binaire ne contient aucune règle. Au premier lancement, Nuclei télécharge les templates communautaires dans
~/nuclei-templates/, et la mise à jour se demande explicitement.
nuclei -update-templatesProuver que votre application est sûre ?
Nous livrons un rapport daté : ce qui a été vérifié, ce qui reste à corriger, et dans quel délai. Sécuriser votre application.
3. Comment fonctionne un scan
Le déroulé
Un scan se lit en quatre temps : chargement des templates retenus, envoi des requêtes que chacun décrit, comparaison des réponses aux critères de détection, restitution des correspondances.
nuclei -u https://integration.mon-projet.fr
nuclei -l cibles.txt
nuclei -l openapi.json -im openapi
L’option -im mérite un arrêt. Nuclei accepte autre chose qu’une liste d’URLs en entrée : list par défaut, mais
aussi burp, jsonl, yaml, openapi et swagger. Le mode OpenAPI déplie les opérations décrites dans un schéma
en requêtes réelles, ce qui règle un angle mort du scanner face à une API : sans schéma, il ne voit que les routes
qu’on a pensé à lui donner.
C’est la fonctionnalité qui nous a le plus intéressés, parce qu’une part de nos applications expose une API dont nous écrivons la définition. Nous verrons en raison 1 qu’elle n’est pas un différenciateur : ZAP importe le même schéma, par le même mécanisme.
Lire une ligne de résultat
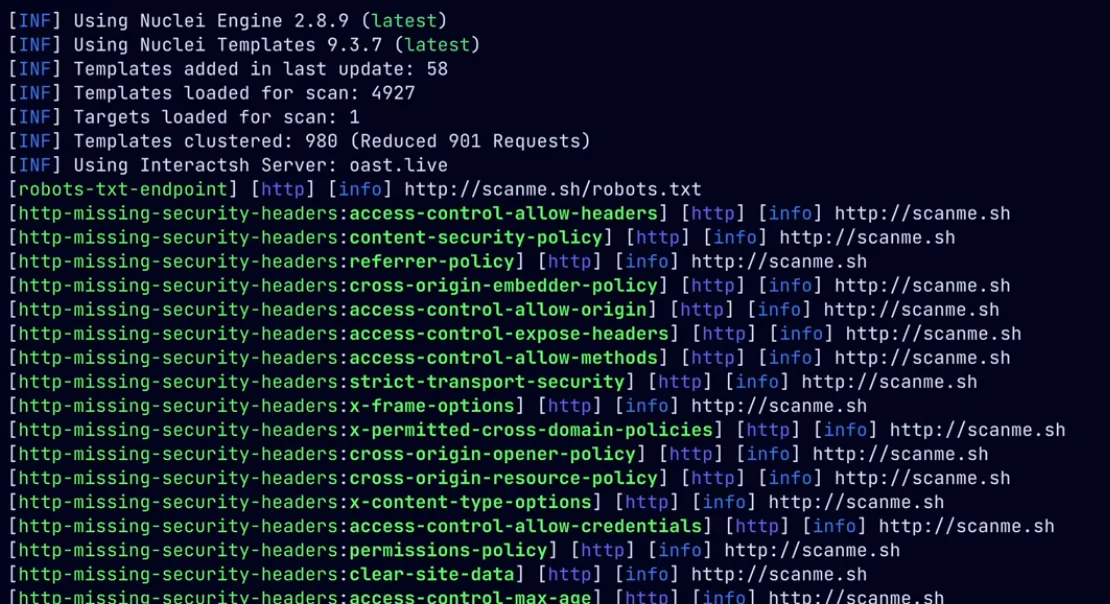
Chaque correspondance suit le même format dans l’output standard, ici sur un endpoint de métriques laissé accessible :
[prometheus-metrics] [http] [medium] https://integration.mon-projet.fr/metricsL’identifiant du template qui a levé l’alerte, le protocole utilisé, la sévérité déclarée, puis l’URL exacte où le problème a été observé. Rien de plus : ni explication du risque, ni correction suggérée. Pour comprendre pourquoi l’alerte est tombée, on ouvre le YAML du template.
Filtrer, sinon on lance treize mille règles
Sans filtre, Nuclei charge la totalité du dépôt communautaire, dont l’écrasante majorité ne correspond à aucune
technologie de votre projet. Pour donner un ordre de grandeur, la version v10.4.8 de nuclei-templates, celle que
nous avons utilisée pour cet article, compte 13 619 templates au total : 11 246 en protocole http, 4 283 portant le
tag cve, et 447 en protocole file. Le fichier TEMPLATES-STATS.md livré avec le dépôt donne le décompte de votre
propre version.
nuclei -u https://integration.mon-projet.fr -tags exposure,misconfig
nuclei -u https://integration.mon-projet.fr -severity critical,high
nuclei -u https://integration.mon-projet.fr -t http/exposures/ -t http/misconfiguration/
nuclei -u https://integration.mon-projet.fr -etags dos,fuzz
Les filtres se cumulent en ET. -t désigne un fichier ou un répertoire et peut être répété, -tags et -severity
restreignent le jeu chargé, -etags exclut. Les deux exclusions à connaître sont dos, qui peut perturber le
service, et fuzz, qui génère un volume de requêtes considérable.
Brider le débit
| Option | Rôle | Valeur par défaut |
|---|---|---|
-rate-limit | Requêtes par seconde, prévaut sur les autres | 150 |
-c | Templates exécutés en parallèle | 25 |
-bulk-size | Hôtes traités en parallèle par template | 25 |
-timeout | Délai maximum par requête, en secondes | 10 |
Scanner derrière une authentification
Sans identifiants, un scan ne voit que la partie publique de l’application. Sur un back-office Symfony, c’est-à-dire
sur l’essentiel de ce que nous construisons, cela revient à ne scanner que la page de connexion. Nuclei accepte donc
des en-têtes arbitraires, jeton Bearer d’une API ou cookie de session d’une application classique.
nuclei -u https://recette.exemple.fr -H "Authorization: Bearer $API_TOKEN" -tags misconfig,exposure
nuclei -u https://recette.exemple.fr -secret-file secrets.yaml
La seconde forme est préférable dès qu’on quitte son propre poste. Un jeton passé en -H se retrouve dans
l’historique du shell et dans la table des processus, donc lisible par tout compte présent sur la machine : sur un
runner de CI partagé, c’est une fuite d’identifiants qu’on s’inflige soi-même. -secret-file lit les identifiants
depuis un fichier dédié, qui reste un secret d’exécution comme un autre.
Les sorties : tout, sauf un rapport HTML
C’est le premier écart concret avec ZAP Proxy, et il se voit dès la fin du premier scan. ZAP produit un rapport HTML autonome, lisible par n’importe qui, archivable en artefact de pipeline et transmissible tel quel à une équipe support sécurité. Nuclei n’a aucun export HTML natif.
| Sortie | Option | Ce qu’on en fait |
|---|---|---|
| Texte | -o | Lecture immédiate, log du job de CI |
| JSONL | -jle | Le format pivot : filtrage jq, comparaison entre deux exécutions, seuil de rupture en CI |
| JSON | -je | Consommation par un autre outil |
| Markdown | -me | Un répertoire, pas un fichier, voir ci-dessous |
-pe | Le seul export natif tenant en un seul fichier | |
| SARIF | -se | Ingestion par une plateforme de code scanning |
| Base de données | -rdb | Historisation, pour comparer dans le temps |
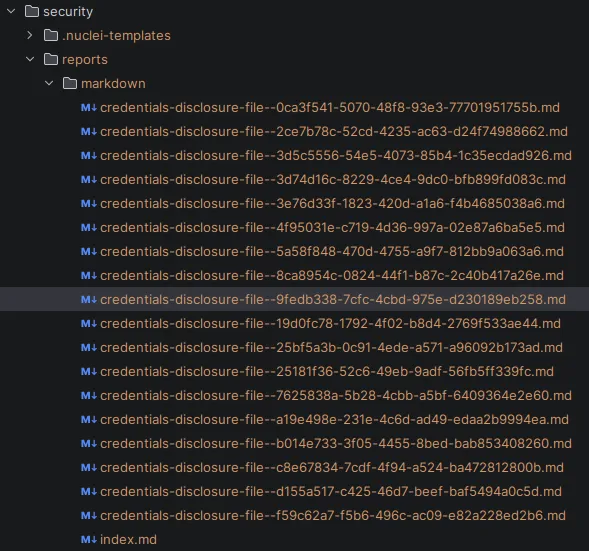
Le format qui s’en rapproche le plus en présentation est le markdown. Sauf que -me n’écrit pas un rapport, il écrit
un répertoire : un fichier par correspondance, nommé [TemplateID]-[Host]-[UUID]-[MatcherName].md, plus un
index.md récapitulatif listant les résultats dans un tableau Hostname, Finding, Severity. Sur un scan qui remonte
quarante alertes, vous obtenez quarante-et-un fichiers. Il n’existe pas de markdown global.
Le seul export mono-fichier natif est le PDF, qui convient à une transmission ponctuelle mais se prête mal à un suivi si on veut par exemple l’historiser via git.
Reste le JSONL, une ligne de JSON par résultat. C’est un format machine, et c’est précisément pour ça qu’il sert de
base : on l’agrège soi-même pour produire un rapport lisible. C’est ce que nous avons fait pendant l’évaluation, avec
un script qui lit le JSONL et génère un report.html autonome, avec en-tête (cible, date, templates utilisés),
synthèse par sévérité et détail de chaque résultat.
Ce n’est pas rédhibitoire, mais c’est du travail que ZAP ne demande pas. Sur un outil qu’on envisage d’ajouter à côté d’un autre, ce genre d’écart se cumule.
4. La notion de template
Anatomie
Un template répond à une seule question : comment détecter ce problème ? Il décrit ce qu’on envoie, ce qu’on cherche dans la réponse, et la conclusion à en tirer.
id: git-config-exposure

info:
  name: Git Config File Exposure
  author: ice3man
  severity: medium
  description: Détecte l'exposition du fichier .git/config
  tags: git,config,exposure

http:
  - method: GET
    path:
      - "{{BaseURL}}/.git/config"

    matchers:
      - type: word
        words:
          - "[core]"
          - "[remote"
        condition: and
Quatre éléments : l’identifiant, le bloc info qui porte le nom, l’auteur, la sévérité et les tags, le bloc de
protocole qui décrit la requête, et les matchers qui décident. {{BaseURL}} est remplacé par la cible à l’exécution.
Ce template accède à /.git/config et lève une alerte si la réponse contient les deux marqueurs d’un fichier de
configuration Git. Une trentaine de lignes de YAML, sans SDK ni compilation : c’est la vraie force de l’outil.
Les matchers, là où se joue la fiabilité
Les types disponibles sont status (code de retour), word (présence d’une chaîne), regex, et dsl pour une
expression. Ils se combinent par matchers-condition: and ou or, et les extractors récupèrent au passage une
information utile de la réponse.
Explorer les templates existants
Ces commandes lisent le dépôt local sans envoyer la moindre requête à une cible.
nuclei -tl
nuclei -tgl
nuclei -t http/cves/2021/CVE-2021-44228.yaml -td
La première liste tous les chemins de templates, la deuxième les tags utilisables avec -tags, la troisième affiche
le YAML d’un template précis. C’est le réflexe à prendre avant d’accorder du crédit à une alerte.
Un piège attend au premier essai : les chemins sont relatifs à ~/nuclei-templates/, et les templates HTTP vivent
sous http/. -t cves/2021/CVE-2021-44228.yaml répond Could not find template, alors que le même chemin préfixé de
http/ fonctionne.
Écrire ses propres règles
Une des forces mises en avant par l’outil est de pouvoir écrire ses propres templates. Les templates communautaires couvrent mal ce qui est propre à votre application, puisque les chemins et les marqueurs varient d’un projet à l’autre.
id: symfony-profiler-exposed

info:
  name: Profiler Symfony accessible
  author: smartbooster
  severity: high
  description: Le Web Profiler expose les requêtes SQL, la configuration et les variables d'environnement.
  tags: symfony,exposure

http:
  - method: GET
    path:
      - "{{BaseURL}}/_profiler"
      - "{{BaseURL}}/_wdt/latest"

    matchers-condition: and
    matchers:
      - type: status
        status:
          - 200
      - type: word
        part: body
        words:
          - "Symfony Profiler"
Notez le matchers-condition: and : le statut seul ne suffit pas, il faut aussi le marqueur dans le corps de la
réponse. C’est presque toujours le bon choix pour une règle destinée à tourner en automatique.
Les protocoles au-delà du HTTP
http couvre la quasi-totalité des besoins applicatifs. À côté, file scanne un répertoire du système de fichiers au
lieu d’une URL, headless pilote un vrai navigateur, et dns, ssl, network et code traitent le reste.
Le faux ami à désamorcer : le protocole javascript n’audite pas le JavaScript exécuté dans le navigateur. C’est un
moteur JS embarqué dans le scanner, prévu pour dialoguer avec des services réseau (SSH, Redis, LDAP) ou construire
des paquets à la main. Pour auditer une application à rendu client, c’est headless et katana qu’il faut regarder.
5. Automatiser le scan
Le cadre légal et l’environnement, avant toute commande
Scanner un système sans autorisation est un délit pénal
Un scan Nuclei génère du trafic actif contre une cible. Ce n’est pas une relecture de code, c’est un test intrusif.
L’article 323-1 du Code pénal punit l’accès ou le maintien frauduleux dans un système de traitement automatisé de données de trois ans d’emprisonnement et 100 000 euros d’amende. La peine passe à cinq ans et 150 000 euros si des données sont supprimées ou modifiées, ou si le fonctionnement du système s’en trouve altéré, et à sept ans et 300 000 euros lorsque le système traite des données personnelles pour le compte de l’État.
Le point que l’on oublie le plus souvent : l’article 323-7 punit la tentative des mêmes peines. Il n’est donc pas nécessaire que le scan aboutisse à quoi que ce soit pour que l’infraction soit constituée, ni qu’il ait causé le moindre dommage.
Deux situations mettent à l’abri, et deux seulement : une autorisation écrite du propriétaire du système, avec un périmètre et une fenêtre d’intervention définis, ou une infrastructure dont on est soi-même responsable. Pour tester un système tiers, les programmes de bug bounty fournissent précisément ce cadre, et leur règlement vaut autorisation dans les limites qu’il pose.
Si vous découvrez une faille sans l’avoir cherchée, il existe une porte de sortie : l’article L2321-4 du code de la défense permet de la signaler de bonne foi à l’ANSSI, qui préserve alors la confidentialité de l’identité de la personne à l’origine du signalement.
Côté technique, les règles sont celles que nous appliquons déjà à nos scans DAST : un environnement d’intégration alimenté par des données factices, iso-production sur les versions et la configuration, et l’hébergeur prévenu. Vu depuis un pare-feu applicatif, un scan ressemble beaucoup à une attaque.
En CI via l’image Docker
nuclei-scan:
  stage: security
  image:
    name: projectdiscovery/nuclei:latest
    entrypoint: [""]
  when: manual
  script:
    - nuclei -ut
    - nuclei -l cibles.txt -severity critical,high -etags dos,fuzz -rl 25
        -jle nuclei/findings.jsonl -o nuclei/findings.txt
    - if [ -s nuclei/findings.jsonl ]; then echo "Findings détectés"; exit 1; fi
  artifacts:
    when: always
    expire_in: 30 days
    paths:
      - nuclei/
L’exemple est simplifié sur un point qui compte : il suppose cibles.txt déjà présent. Ce fichier est la surface
de scan, et Nuclei ne sait pas la produire. Sur une application dont les routes ne se devinent pas depuis la racine du
domaine, il faut la générer en amont avec katana, qui crawle le site et sort la liste des URLs atteignables.
En pratique, cela fait deux jobs consécutifs plutôt qu’un, chacun tournant sur son image, le premier passant son résultat au second par les artefacts de la pipeline.
katana-crawl:
  stage: security
  image:
    name: projectdiscovery/katana:latest
    entrypoint: [""]
  script:
    - katana -u https://integration.mon-projet.fr -jc -d 3 -f url -o cibles.txt
  artifacts:
    paths:
      - cibles.txt

nuclei-scan:
  needs:
    - job: katana-crawl
      artifacts: true
  # le reste du job, identique à l'exemple précédent
Si l’application a un rendu client, le crawl demande le mode headless, donc l’image katana reconstruite évoquée plus
haut. Et si la surface est stable et connue, un cibles.txt versionné dans le dépôt reste la solution la plus simple :
le crawl n’a d’intérêt que sur une application dont les routes bougent.
Le seuil de rupture se pose sur le fichier JSONL : la pipeline échoue s’il n’est pas vide. En pratique on affine, en comparant les identifiants de templates à une liste de référence pour ne faire échouer le job que sur les nouveautés.
GitHub a son action officielle, GitLab non
C’est un point à connaître avant de s’engager. ProjectDiscovery ne documente officiellement qu’une intégration :
l’action GitHub projectdiscovery/nuclei-action@v3.
      - name: Run Nuclei
        uses: projectdiscovery/nuclei-action@v3
        with:
          args: -u https://example.com
Sur GitHub, l’export SARIF est ingéré nativement par l’onglet Security et les vulnérabilités apparaissent dans l’interface (si le dépôt est public, sinon il faut a minima le plan tarifaire GitHub Code Security).
Sur GitLab, rien de tout ça : pas d’action officielle, et le SARIF se conserve en artefact, son ingestion native dépendant du niveau de licence. On repasse donc par l’image Docker, comme ci-dessus. Ce n’est pas bloquant, mais c’est un coût d’intégration qui reste à la charge de l’équipe.
Le cas à part : scanner un répertoire de build en local
Une capacité que ZAP n’a pas du tout, et qui ne demande ni serveur, ni réseau, ni autorisation.
nuclei -file -target dist/ -t file/keys/Avec le protocole file, Nuclei applique ses matchers au contenu des fichiers au lieu des réponses HTTP. Sur le
dist/ d’un build front, on attend de lui qu’il attrape les régressions typiques : une source map réactivée, un
secret inliné dans le bundle.
Noter le -t file/keys/, qui n’est pas un détail de confort. Le catalogue file/ complet vise des systèmes de
fichiers compromis, serveurs et postes de travail, et non des artefacts de build : le lancer entier sur un dist/
coûte très cher pour ce qu’il rapporte. Nous l’avons mesuré sur ce site, les chiffres sont plus bas.
Un job de CI qui build puis scanne son propre dist/ ne demande aucune autorisation d’infrastructure. C’est le seul
usage de Nuclei qui ne recoupe rien de notre chaîne actuelle.
6. Pourquoi nous ne l’avons pas retenu dans notre suite sécurité
Le duo ZAP plus Nuclei que l’on lit partout
La recommandation existe, elle est répétée dans la plupart des guides, et elle n’est pas absurde. Sur un périmètre de test d’intrusion ou de bug bounty, les deux outils se complètent réellement : l’un explore et attaque en profondeur une application, l’autre balaie vite et large une surface qu’on découvre.
Mais ce périmètre n’est pas le nôtre. Nous auditons des applications que nous avons construites, dont nous connaissons les routes, la stack et l’hébergement chez Clever Cloud. La découverte de surface, principale valeur de la suite ProjectDiscovery, est déjà acquise avant le premier scan. Un conseil pertinent dans un contexte ne l’est pas mécaniquement dans un autre.
Raison 1 : un recoupement large avec ZAP Proxy
Mis à plat, l’essentiel de ce que Nuclei apporterait est déjà couvert, soit par ZAP, soit ailleurs dans notre chaîne.
flowchart TB
  subgraph Zap["Déjà couvert par ZAP Proxy"]
    Z1["Crawl d'une application JS<br/>spider et spider AJAX"]
    Z2["En-têtes, cookies, fuites<br/>scan passif"]
    Z3["Injections SQL, XSS, traversée<br/>scan actif"]
    Z4["Sonde de chemins connus<br/>règles du scan actif"]
    Z5["Dépliage d'un schéma d'API<br/>add-on OpenAPI"]
  end
  subgraph Chaine["Déjà couvert ailleurs dans notre chaîne"]
    C1["CVE des dépendances PHP<br/>composer audit"]
    C2["CVE des dépendances JS<br/>npm audit"]
    C3["CVE de l'image Docker<br/>OSV Scanner"]
  end
  subgraph Reste["Ce que Nuclei ajoute réellement"]
    N1["Scan d'un répertoire de build<br/>protocole file"]
  end
  style Reste fill:#0f766e,color:#fff
Le recoupement le plus frontal concerne le fuzzing.
Les templates dast/ de Nuclei injectent des charges dans les paramètres pour détecter injections SQL, SSRF et XSS :
c’est exactement la famille d’attaques du scan actif de ZAP, sur les mêmes paramètres. Ajouter les deux, c’est payer
deux fois le même test et trier deux fois les mêmes alertes.
Le recoupement va jusqu’aux vulnérabilités aveugles, celles qui ne se voient pas dans la réponse HTTP. Une SSRF ou une exécution de code à distance sans retour ne se détecte qu’en observant si la cible contacte un serveur tiers après l’injection. Nuclei le fait avec Interactsh, actif par défaut : il insère des URLs d’écoute dans ses charges et guette le rappel. C’est le mécanisme d’OAST, et ZAP a le sien, via son extension du même nom. Là encore, deux outils pour la même détection.
La sonde de chemins connus n’est pas le gain net qu’on croit, et c’est l’erreur que nous avons nous-mêmes faite
au premier examen. Le scan actif de ZAP embarque des règles qui font exactement ce travail, chacune sur sa cible :
.env, .htaccess, /WEB-INF, ELMAH, Trace.axd, Spring Actuator, métadonnées cloud, plus un Hidden File Finder
générique. Comme les templates de Nuclei, elles testent une liste choisie de chemins sensibles et vérifient ce qui
revient. Et elles tournent en ligne de commande, donc en CI.
L’extension Forced Browse, qu’on range volontiers dans
la même case, répond à une autre question. Héritée de DirBuster, elle essaie des milliers de noms tirés d’un
dictionnaire pour découvrir des pages que rien ne relie. Elle ne s’utilise que depuis l’interface graphique, et sur
un front statique, un find dist répond à la même question sans rien deviner.
Nous l’avons mesuré sur ce site. Des 52 règles actives de ZAP, 33 ont besoin d’un point d’injection, absent d’un front statique. Sur les 19 qui restent applicables, dix sondent un chemin connu, cinq cherchent une exécution de code déclenchée par un en-tête ou un chemin, quatre portent sur le transport et la négociation. Autrement dit, le terrain que nous attribuions à Nuclei est précisément celui que ZAP occupe encore quand tout le reste ne s’applique plus.
Le même raisonnement vaut pour le dépliage d’un schéma d’API. Le -im openapi vu plus haut a son équivalent chez ZAP,
l’add-on OpenAPI Support, qui importe une définition et
en alimente le crawl. Sur une API dont nous écrivons le schéma, les deux outils repartent de la même entrée.
Il ne reste alors qu’un seul gain vraiment propre à Nuclei : le scan d’un répertoire de build par le protocole file,
que ZAP ne peut pas faire faute de serveur HTTP en face. C’est peu, et c’est justement ce que nous avons voulu vérifier
sur le terrain le plus favorable qui soit.
Raison 2 : la CVE est déjà traitée, plus tôt et plus sûrement
Notre chaîne traite les vulnérabilités connues à la source, par un audit de dépendances à chaque étage :
composer audit sur les dépendances PHP, npm audit sur les paquets front, OSV Scanner sur les paquets système de
l’image Docker, et un suivi de versions qui empêche la dette de s’installer.
Cette couverture ne dépend pas du mode de rendu : elle est identique sur une application Twig, sur un back-office Vue et sur un front statique, puisqu’elle lit des fichiers de verrouillage et non des pages servies.
Les templates cve/ de Nuclei travaillent dans l’autre sens : ils déduisent une version vulnérable de l’extérieur, par
empreinte. C’est plus tard dans le cycle, moins fiable qu’une lecture de composer.lock ou d’un package-lock.json,
et la correction reste strictement la même. Sur ce terrain, un scanner externe confirme au mieux ce que l’analyse des dépendances a déjà dit.
Raison 3 : des templates communautaires sans standard de référence
C’est l’argument qui a pesé le plus lourd.
Les règles de ZAP viennent d’un projet à la gouvernance établie : porté par l’OWASP pendant treize ans, puis par la Software Security Project de la Linux Foundation, et soutenu par Checkmarx depuis septembre 2024 sans changer de licence ni d’équipe. Chaque alerte porte un identifiant stable, une page de documentation qui explique le risque et la correction attendue, et un niveau de confiance annoncé par l’outil lui-même.
Les templates Nuclei sont d’une autre nature. Ce sont des contributions communautaires, plus de treize mille, sans organisme de référence qui en valide la pertinence. Leur qualité est très inégale, et rien ne la signale de l’extérieur : un template écrit avec soin et un template approximatif se présentent exactement pareil dans la sortie du scan, avec la sévérité que son auteur a bien voulu déclarer.
Évaluer une règle suppose donc de lire son YAML et de juger ses matchers, comme vu plus haut. Il en découle deux conséquences, et la seconde est la plus coûteuse :
- Un risque de faux positif théoriquement plus élevé qu’avec ZAP, dont le jeu de règles est stabilisé et documenté alerte par alerte.
- Un coût de tri qui retombe sur l’équipe à chaque exécution. Une alerte dont on ne sait pas si elle est fiable doit être vérifiée à la main. Le bruit d’alerte a un effet connu : un scan dont on doute finit par ne plus être lu, et un scan qu’on ne lit plus ne protège de rien.
Il existe un flag qui promet d’aider à ce tri, et il faut le regarder de près plutôt que l’ignorer. Comme l’explique
Stéphane Robert dans son guide de Nuclei,
l’option -ms, pour matcher-status, affiche l’état des matchers et aide à distinguer un vrai positif d’un faux.
Nous ne la connaissions pas avant de lire son article, merci à lui.
Nous l’avons donc mise à l’épreuve sur l’un des plus bruyants de nos résultats, le template php-scanner, relancé
sur le même build avec et sans l’option.
# sans -ms
[php-scanner] [file] [info] /scan/404.html ["exit","die","and","header"]

# avec -ms
[php-scanner] [matched] [file] [info] /scan/404.html ["exit","die","and","header"]
245 lignes dans les deux cas, à un libellé près. Le flag ajoute [matched], et rien de plus : la liste des mots
trouvés était déjà là. Il est conçu pour le protocole http, où il expose aussi les matchers qui ont échoué et aide
à comprendre pourquoi un template ne se déclenche pas. Sur le protocole file, il n’apporte rien.
Surtout, il ne répond pas à la question qui nous occupe. -ms confirme que php-scanner a bien trouvé le mot exit
dans une page HTML : le matcher a fonctionné, la règle a fait exactement ce qu’elle décrit. Le problème n’est pas là.
Il est qu’une règle qui cherche le mot exit dans un fichier n’a aucune valeur de détection sur un site sans PHP, et
aucun flag ne le dira. Ce jugement se rend en lisant le YAML, ou il ne se rend pas.
Dernier point, à traiter sans dramatiser : un template est du contenu exécutable tiré d’un dépôt public et rafraîchi à
chaque -update-templates. ProjectDiscovery en a d’ailleurs tiré les conséquences sur le protocole le plus sensible,
puisque depuis la version 3.11 un template
personnalisé utilisant le protocole javascript doit être signé pour être chargé, les templates officiels étant
pré-signés et vérifiés avec la clé publique du projet. C’est une bonne mesure, et elle rappelle que la question de
la confiance se pose.
Raison 4 : deux scanners, deux fois le coût de fonctionnement
Un outil ne coûte pas ce qu’il coûte à installer, il coûte ce qu’il coûte à faire vivre. Deux scanners, ce sont deux formats de rapport, deux listes de faux positifs à qualifier avec le client, deux configurations de périmètre à tenir à jour, et deux outils à expliquer dans un cadrage.
Le vrai arbitrage n’est donc pas « ZAP ou Nuclei », il est « un scanner ou deux ». Formulé ainsi, la question devient tranchable : le second doit rembourser son coût de fonctionnement par du gain de couverture, pas par du confort de découverte.
Le test grandeur nature : notre propre build
Un arbitrage sur dossier ne vaut pas grand-chose. Nous avons donc branché Nuclei sur le build de ce site, un front
statique généré par Astro, et lancé le protocole file sur les 137 Mo de dist/, images comprises.
Le choix de la cible n’est pas neutre, et il est censé jouer contre notre stack actuelle. Un site statique buildé
par Astro est le contexte le plus favorable à Nuclei parmi tous nos projets : c’est le seul où le protocole file
s’applique, c’est-à-dire le seul gain qui ne recoupe rien. Si l’arbitrage tient ici, il tient a fortiori sur une
application Symfony, où ZAP couvre en plus tout le champ applicatif.
Le catalogue file/ communautaire compte 447 templates. Le scan a duré près de 25 minutes et remonté
818 résultats, dont pas un seul vrai positif. Les principaux contributeurs au bruit :
| Template | Remontées | Sévérité déclarée | Ce qu’il a réellement matché |
|---|---|---|---|
dom-invader-xss | 263 | high | JSON.parse et fetch |
php-scanner | 245 | info | exit, die, and, header dans des pages HTML, sur un site sans PHP |
credentials-disclosure-file | 134 | unknown | PWd= dans un .webp binaire, ref_key: généré par Vue |
js-analyse | 103 | info | les imports de nos propres chunks |
url-extension-inspector | 55 | unknown | la chaîne .db |
*-framework-exceptions | 14 | info à medium | des traces d’exception ASP.NET, Django et Node sur un site Astro |
linkedin-id | 2 | low | notre propre URL LinkedIn, celle du pied de page |
C’est la raison 3 démontrée par les chiffres plutôt que par le raisonnement. Un template high qui matche fetch, un
medium qui cherche des exceptions Django sur un site qui n’exécute pas une ligne de Python : la sévérité est
déclarative, et rien dans la sortie ne distingue une règle solide d’une règle approximative. L’explication tient à la
vocation du catalogue, qui vise des systèmes de fichiers compromis, serveurs et postes de travail, et non des
artefacts de build.
Le temps de scan mérite lui aussi une explication, parce qu’il est contre-intuitif. Le protocole file lit chaque
octet du répertoire et lui applique l’ensemble des matchers chargés. Le coût est donc linéaire en poids, pas en nombre
de pages : nos deux plus grosses images, 6,8 Mo et 1,6 Mo, coûtent à elles seules plus cher que tout le HTML du site.
Sur une CI facturée à la minute, vingt-cinq minutes pour zéro information est un prix qu’on ne paie pas deux fois.
Restreindre le catalogue rend le scan exploitable. file/keys/ est la seule famille qui ait une chance de trouver
quelque chose de réel dans un artefact de build, à savoir un secret inliné dans un bundle. En écartant deux de ses
templates pour une raison structurelle et non pour faire taire un résultat gênant, credentials-disclosure-file dont
la regex matche PWd= en base64 dans n’importe quelle image, et linkedin-id qui matche notre propre pied de page,
il reste 155 règles, trois minutes d’exécution et zéro remontée.
Zéro est le bon résultat : il n’y a effectivement rien à trouver. Mais nous l’avons obtenu en écrivant nous-mêmes la liste de ce qu’il ne fallait pas écouter, c’est-à-dire en faisant à la place de l’outil le travail de tri que nous attendions de lui.
Reste la règle maison, celle qui devait justifier l’outil : détecter une source map livrée dans le build, qui
republierait le code source du front. Elle fonctionne, une vingtaine de lignes de YAML ont suffi, et elle ne remonte
rien puisque Astro n’en publie aucune. Mais find dist -name '*.map' répond exactement à la même question, en une
ligne et sans scanner. Le gain net que nous pensions avoir identifié ne survit pas à sa mise à l’épreuve.
Ce qu’un build local ne peut pas dire
Une précision, pour ne pas conclure trop large : trois familles de vérifications échappent à un scan de répertoire.
- Les headers de sécurité.
X-Frame-Options,Content-Security-PolicyouReferrer-Policysont posés par le serveur et par l’hébergeur, jamais par le générateur. Ils sont absents du build par construction. - La configuration TLS. Certificat, chaîne de confiance, suites de chiffrement : tout appartient à l’hôte.
- Les chemins servis hors du build. Un
.git/ou un.envlaissé à la racine du serveur ne se trouve pas dansdist/, mais reste servi si la racine est mal cadrée.
Nous avons voulu couvrir ces trois familles par une commande de scan dédiée, et le périmètre s’est vidé pendant qu’on le mesurait.
Les headers, d’abord, n’imposent pas d’aller en production. Le CLI de notre hébergeur sert le build avec le fichier de configuration réel du site, redirections comprises. Les six en-têtes arrivent tels qu’ils sont déclarés, CSP incluse, et les 301 répondent. La configuration est donc entièrement vérifiable hors production.
Mais pas avec un scanner. Les 334 templates de ce périmètre, lancés sur ce serveur local, l’ont fait tomber au
bout de 301 requêtes et douze secondes, à 25 requêtes par seconde, sur une erreur interne de son proxy. Un serveur de
développement n’encaisse pas ce qu’encaisse un CDN : passé ce point le scan ne mesure plus la configuration du site,
il mesure la robustesse du serveur de test. Un curl -sI répond à la même question en une requête, et sans ambiguïté
sur ce qu’il mesure.
Il reste alors deux vérifications, et aucune n’est un scan. Un curl -sI sur le domaine de production pour
confirmer que les en-têtes arrivent bien et qu’aucune dérive ne s’est glissée entre le dépôt et la console de
l’hébergeur. Un test TLS en lecture seule pour le certificat et les suites de chiffrement. Quant aux chemins servis
hors du build, ils se cherchent dans le build, avec find.
Notre dépôt n’a donc aucune commande qui scanne la production. Ce n’est pas une précaution timide, c’est ce qui reste une fois qu’on a demandé à chaque vérification quel outil la sert le mieux.
ZAP sur la même cible, pour comparer ce qui est comparable
Le même site, servi en local avec ses vrais en-têtes, passé au scan passif de ZAP.
3 min 18 s 1692 URLs, 7 avertissements, 60 règles passées, 0 échec bloquantZAP se trompe aussi, et il faut le dire. Sur les onze avertissements du premier rapport, quatre étaient des faux positifs, soit plus d’un tiers :
| Alerte | Sévérité annoncée | Ce que c’était |
|---|---|---|
PII Disclosure | High | Les cartes de test publiques de Stripe, citées en documentation |
Source Code Disclosure - SQL | Medium | Des exemples SQL affichés volontairement, sur les pages qui parlent de SQL |
Suspicious Comments | Informational | Les mots DB et ADMIN dans les légendes de nos schémas SVG |
Content-Type Header Missing | Informational | Un artefact du serveur de développement, absent en production |
La plus haute sévérité du rapport était un faux positif. Exactement comme chez Nuclei.
La différence n’est pas le taux d’erreur, c’est ce qu’on peut en faire
Les deux outils se trompent. Ce qui les sépare, c’est ce qui reste possible après.
Une alerte ZAP porte un identifiant de règle stable, une page de documentation, et un niveau de confiance que l’outil annonce lui-même. On peut donc la juger sans lire son code, puis la classer en faux positif sur une URL précise, avec un motif écrit à côté. Les quatre lignes ci-dessus sont sorties du rapport de cette façon, et le rapport est passé de onze avertissements à sept sans qu’on ait rien caché : chaque filtre porte sa justification, relisible.
Une remontée Nuclei porte un identifiant de template et une sévérité déclarée par son auteur. Pour savoir ce qu’elle vaut, il faut ouvrir le YAML et juger le matcher. Un template soigné et un template approximatif se présentent identiquement dans la sortie. Sur 818 lignes, ce travail ne se fait pas, et un rapport qu’on ne peut pas trier finit par n’être plus lu.
C’est la raison 3, vérifiée dans les deux sens : le problème n’a jamais été que Nuclei produit des faux positifs, tous les scanners en produisent. Le problème est qu’il ne donne pas de quoi les écarter une bonne fois.
Une précision sur le scan actif, pour ne pas conclure de travers
Le scan actif de ZAP n’a rien remonté sur ce site, et ce constat ne se généralise pas. Au réglage par défaut il a crawlé 1743 URLs pour 75 règles, sur un site qui n’offre aucun point d’injection : pas de query string, pas de POST, le formulaire de contact est externalisé. En bornant le périmètre aux 19 règles qui s’appliquent réellement, le résultat est le même, zéro remontée, en une fraction du temps.
Cela dit quelque chose du site, pas de l’outil. Sur une application Symfony avec ses formulaires, ses paramètres et sa session, les 33 règles inertes ici redeviennent le coeur du sujet. Le scan actif garde toute sa valeur là où il y a quelque chose à attaquer.
Nuclei et ZAP Proxy, mis face à face
Les deux outils font du test dynamique sur une application déployée, et c’est à peu près tout ce qu’ils ont en commun. L’un balaie large une surface qu’on découvre, l’autre creuse une application qu’on connaît.
| Critère | Nuclei | ZAP Proxy |
|---|---|---|
| Nature | Moteur de règles déclaratives, un fichier YAML par test | Proxy d’interception et scanner applicatif complet |
| Découverte de la surface | Aucune : la liste des cibles est une entrée, produite par katana ou écrite à la main | Spider et spider AJAX intégrés, la surface est un résultat |
| Détection par chemins connus | Point fort : .env, .git/config, sauvegardes, panneaux d’administration | Présent aussi : extension Forced Browse, plus une quinzaine de règles actives dédiées |
| Dépliage d’un schéma d’API | Mode -im openapi en entrée | Add-on OpenAPI Support, la définition alimente le crawl |
| Injections SQL, XSS, traversée | Templates dast/ et moteur de fuzzing | Scan actif, c’est son coeur de métier |
| CVE par empreinte de version | Plusieurs milliers de templates cve | Couverture marginale, ce n’est pas son objet |
| Scan d’un répertoire local | Protocole file, sans serveur ni réseau, mais catalogue inadapté à un build | Impossible, ZAP a besoin d’une cible HTTP |
| Gouvernance des règles | Contributions communautaires, sans organisme de validation | Équipe cœur stable depuis 2010, alertes documentées et niveau de confiance annoncé |
| Écriture d’une règle maison | Une trentaine de lignes de YAML, sans compilation | Script Zest, Python ou JavaScript, ou greffon Java |
| Rapport lisible par un tiers | Aucun export HTML natif, JSONL à agréger soi-même | Rapport HTML autonome, archivable en artefact |
| Intégration CI | Action GitHub officielle, image Docker ailleurs | Actions GitHub officielles, image Docker et mode démon |
| Terrain de prédilection | Reconnaissance, bug bounty, parc d’actifs mal cartographié | Audit d’une application dont on maîtrise le périmètre |
La lecture en diagonale du tableau donne la clé de notre arbitrage : une seule ligne voit Nuclei gagner sans partage, le scan d’un répertoire de build. Et cette ligne ne tient pas entièrement à l’épreuve, comme la mesure l’a montré : la capacité existe, mais le catalogue qui la sert vise des systèmes de fichiers compromis, pas des artefacts de build. Un gain unique, et déjà entamé, ne paie pas un second scanner dans la chaîne, son bruit à trier et ses règles à maintenir.
7. Le choix d’un outil n’est pas un acte neutre
Cet article est long, et ce n’est pas un accident. La question qui l’ouvre, « faut-il ajouter cet outil à notre chaîne ? », reçoit aujourd’hui une réponse en trois secondes. Demandez-la à un modèle de langage, cherchez-la dans un comparatif en ligne, ouvrez n’importe quelle liste des outils DevSecOps à connaître : la réponse est presque toujours oui, et très souvent le fameux duo ZAP plus Nuclei.
Ces réponses ne sont pas fausses. Elles sont sans contexte. Elles décrivent des outils, là où la seule question qui décide porte sur le recoupement avec ce qui tourne déjà chez vous. Personne d’autre que vous ne connaît votre chaîne, et aucune synthèse ne peut donc trancher à votre place.
Nous en avons fait les frais dans cet article même. Une version antérieure affirmait que ZAP ne sonde pas les chemins connus, et que c’était le point fort de Nuclei. C’est faux. Cette affirmation, nous ne l’avions pas inventée, nous l’avions reprise, parce qu’elle circule partout et qu’elle a l’air raisonnable. Il a fallu installer les deux outils, lancer les scans, lister les 52 règles actives de ZAP et les classer une à une pour découvrir que la moitié de ce qui reste applicable sur un site statique sonde précisément des chemins connus.
L’IA accélère l’analyse, elle ne la remplace pas
Nous utilisons l’intelligence artificielle tous les jours, et sur ce travail aussi : pour cartographier un écosystème d’outils, lire un template YAML inconnu, dépouiller un rapport de scan, rédiger une règle maison. C’est un gain de temps considérable et il n’y a aucune raison de s’en priver.
Ce qu’elle ne fait pas à notre place : lancer le scan et attendre 24 minutes, compter les 818 remontées, ouvrir les 134 lignes d’un même template pour constater que sa regex matche des images, ou vérifier qu’un add-on est bien présent dans l’image Docker qu’on utilise. Une synthèse produite sans ces vérifications a l’air juste. C’est même son principal danger : elle est plausible, bien écrite, et elle reconduit les erreurs du corpus qu’elle résume, dont celle que nous venons de corriger.
L’IA qui accélère le travail est un levier. L’IA à la place du travail produit un avis qui ressemble à une analyse. La différence ne se voit pas à la lecture, elle se voit six mois plus tard, quand l’outil ajouté sans raison est toujours dans la chaîne, que ses alertes ne sont plus lues et que personne ne sait plus pourquoi il est là.
Ce que coûte l’analyse, et ce que coûte de ne pas la faire
L’évaluation racontée ici, c’est une installation, un template maison à écrire, plusieurs campagnes de scans à relancer parce qu’un chiffre ne se reproduisait pas, un rapport à dépouiller alerte par alerte, et une conclusion à réécrire après avoir constaté qu’un de nos arguments était faux.
En face, le coût de l’outil qu’on n’ajoute pas se compte en années : une configuration à maintenir, des templates à mettre à jour, et surtout des alertes à trier à chaque exécution. C’est le calcul que nous faisons avant chaque ajout à une chaîne d’outillage, chez nous comme sur les projets que nous suivons, et il justifie largement pour nous le temps qu’il demande.
Conclusion
Nuclei est un excellent scanner de vulnérabilités, et cet article ne dit pas le contraire. Il est rapide, ses templates sont lisibles, sa communauté réagit en quelques heures à une CVE majeure.
Notre conclusion ne porte pas sur sa qualité mais sur une position. Nuclei est fait pour regarder une cible de l’extérieur, sans en connaître le code ni les dépendances : reconnaissance, surface d’attaque d’un tiers, parc d’actifs mal cartographié. Sur une surface qu’on découvre, c’est l’outil qu’il faut, et il est difficile à remplacer.
Nous sommes à l’intérieur de nos projets. Le dépôt, la chaîne d’intégration et les verrous de dépendances sont sous la
main, et ce que Nuclei devine, nous le savons déjà : l’analyse statique lit le code, composer audit et npm audit
connaissent les CVE de nos dépendances avant la mise en production, ZAP Proxy couvre l’application une fois servie.
L’avantage comparatif de Nuclei, deviner ce qu’on ignore, ne se paie que si l’on ignore quelque chose.
Le recoupement s’est d’ailleurs révélé plus large que nous ne le pensions. Nous attribuions à Nuclei la sonde de chemins connus, avant de vérifier que ZAP la fait aussi, par son extension Forced Browse et par une quinzaine de règles actives dédiées. Cette correction a resserré le gain net au lieu de le nuancer, et c’est le genre d’erreur qu’un comparatif écrit sans mesurer reproduit indéfiniment.
Ce qui vaut d’être repris, c’est la méthode plutôt que le verdict. Cartographiez le recoupement avec l’existant, demandez au candidat quel manque précis il complète, puis testez-le sur le contexte qui l’avantage le plus, pas sur celui qui vous arrange : si le gain ne se voit pas là, il ne se verra nulle part. Une suite d’outils ne se construit pas par accumulation, chaque ajout se paie en tri d’alertes, en configuration et en maintenance évolutive, et doit être remboursé par un gain mesuré.
C’est exactement le raisonnement que nous menons sur les projets que nous suivons, et il vaut aussi bien pour un audit technique ponctuel que pour une chaîne d’outillage qu’on fait vivre pendant des années, comme celle qui sert à sécuriser une application Symfony que nous exploitons. Un arbitrage d’outillage se documente, se chiffre et s’assume, y compris quand il faut revenir sur ce qu’on croyait savoir.
Liens utiles
- ProjectDiscovery : quickstart et outils open source
- Nuclei : documentation officielle
- Nuclei : options d’exécution et formats de sortie
- Nuclei : intégration CI/CD
- Structure d’un template
- Signature des templates
- Le dépôt des templates communautaires
- Katana : le crawler de la suite
- Le guide Nuclei de Stéphane Robert, la référence francophone pour prendre l’outil en main
- PDTM : le gestionnaire d’installation
- Audit sécurité en blackbox avec ZAP Proxy : le guide DAST
- Auditer vos Dockerfile : sécurité, CVE et bonnes pratiques
Le cadre légal, sur Légifrance :